煜见的企业 RAG 知识库要解决的是一件具体的事:回答必须回到已经审过的资料。资料没有入库、片段对不上问题、或者答完无法标出来源,就不应该组织成对外答案。
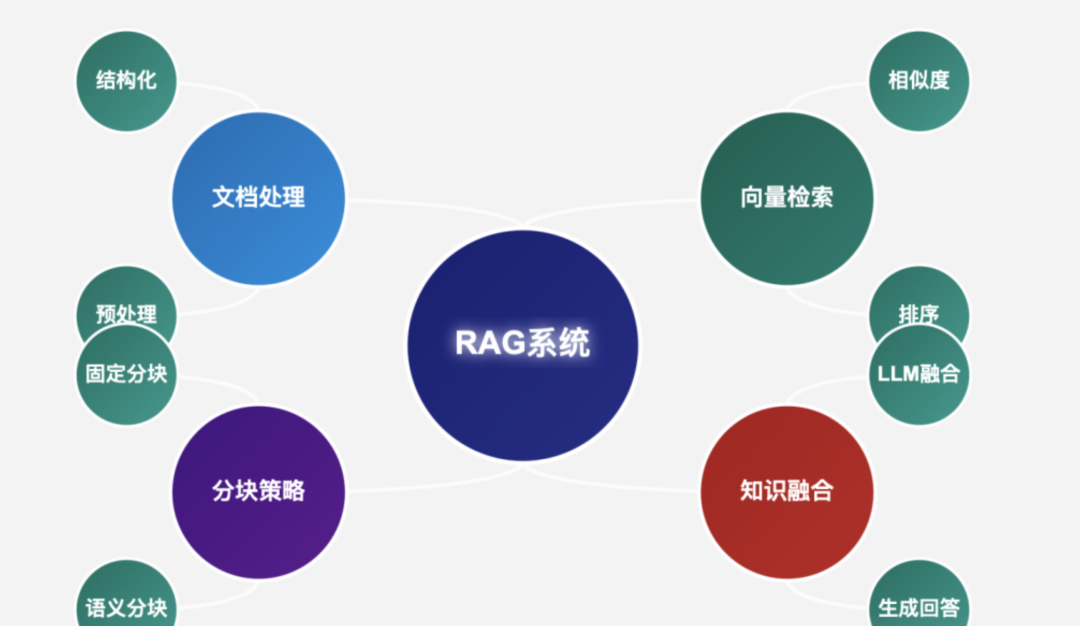
建库和回答分成两条线
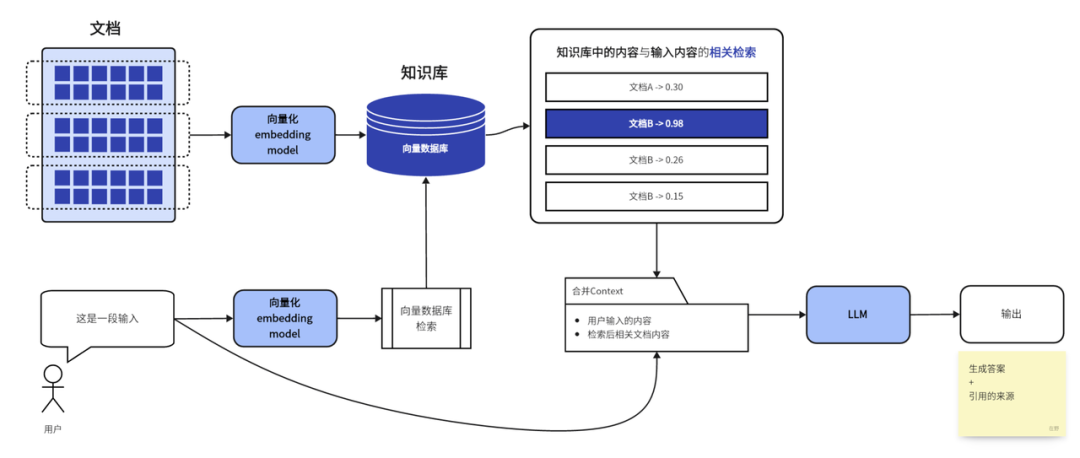
建库时,先解析允许进入的文档,切成可以单独引用的片段,再把片段写成向量保存起来。有人提问时,先按问题召回相关片段,再把问题和这些片段交给模型组织成话。问题本身也要留在提示里,用来约束模型,避免它离开资料自由发挥。
什么资料可以进库
只放入已经核对、并且写明可以使用范围的文本。制度、产品说明、培训材料和已经公开的页面,可以按主题入库。未审核的聊天记录、访客临时粘贴的内容,以及无法标出来源的段落,不进入知识库。
官网这项产品的演示不接收上传,也不保存访客对话。顶栏里的助手只会把问题发给阿里云 DashScope 和火山引擎豆包,并只结合本站已经公开的资料作答。
切块决定后面能不能找对
整篇文档直接做成一个向量,问句往往对不上一小段事实。切块是把文档分成可引用的片段,并保留它属于哪一篇、哪一节。
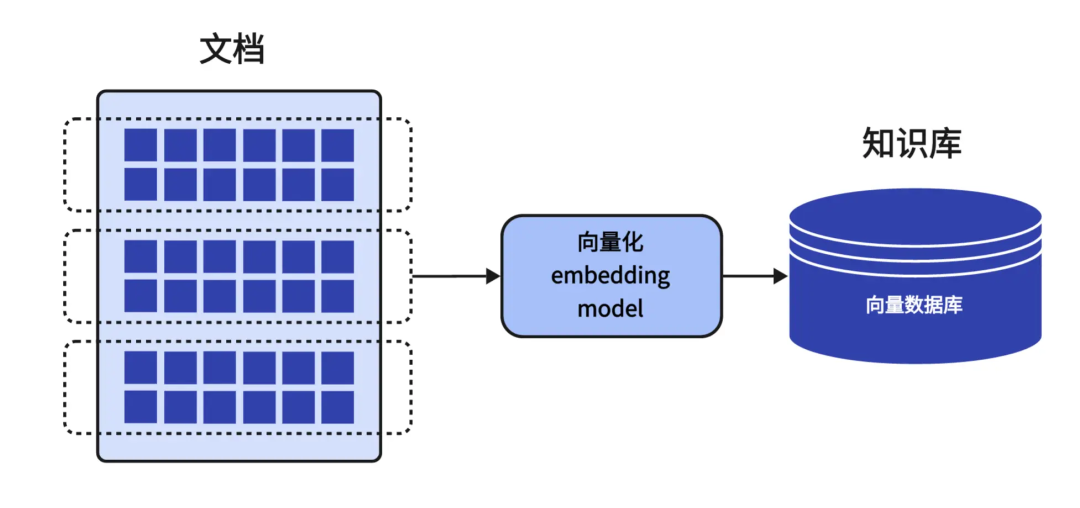
固定长度切块速度快,适合规章和表格,但容易从句子中间切开。按标题、段落和句义来切,更适合问答和说明文。层级切块先保留章节,再拆到段落:检索时可以先定位章节,再取出具体段落。
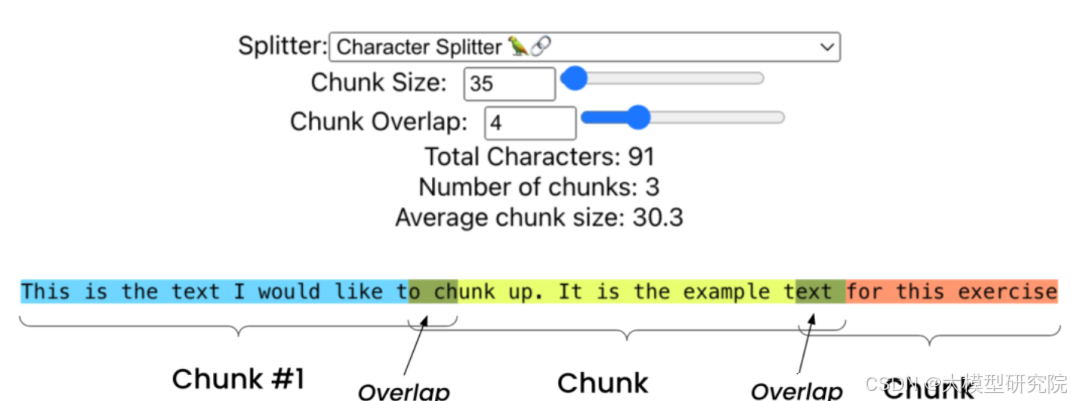
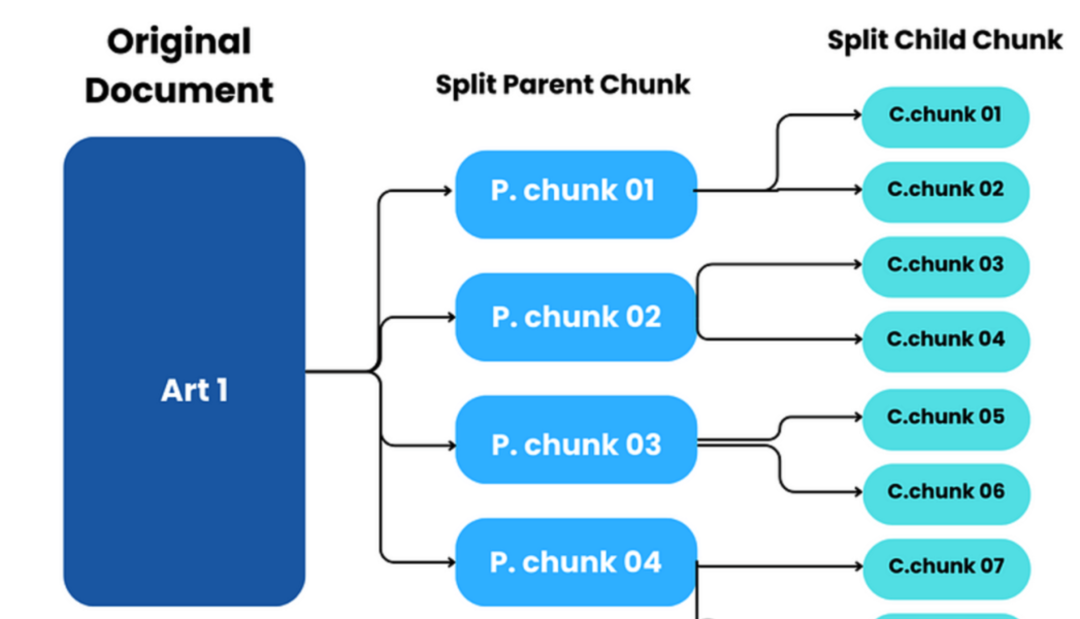
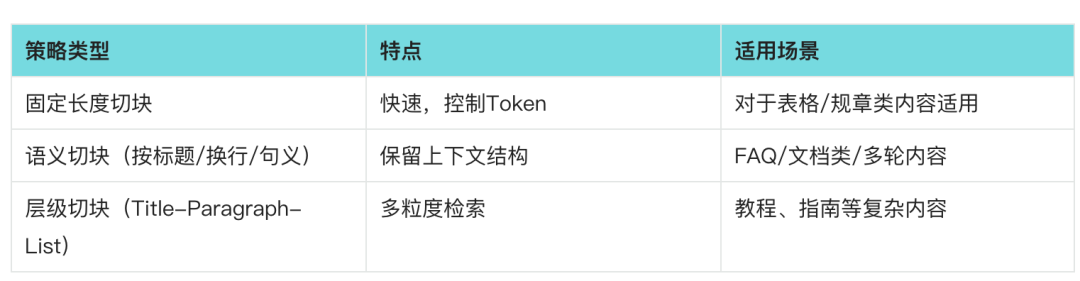
相邻片段保留一小段重叠,是为了不把一句话切成两半之后两边都失去主语。父块用来保住章节语境,子块用来精确命中。回答时展示子块,并标出它所属的父块和原文档。
嵌入、向量库和检索
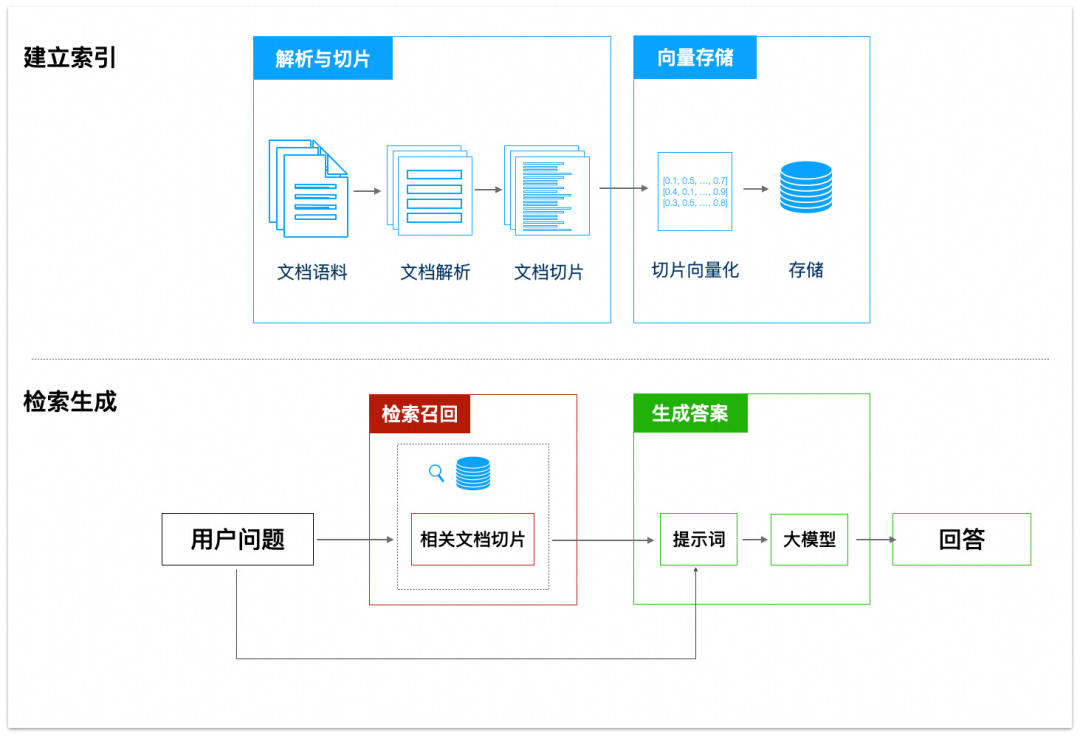
嵌入模型把片段和问题变成同一空间里的向量。中文资料要选用能稳定处理中文的模型,而且建库和提问必须使用同一个模型。中途更换模型,就要把库重新做一遍,不能把两套向量混在一起检索。
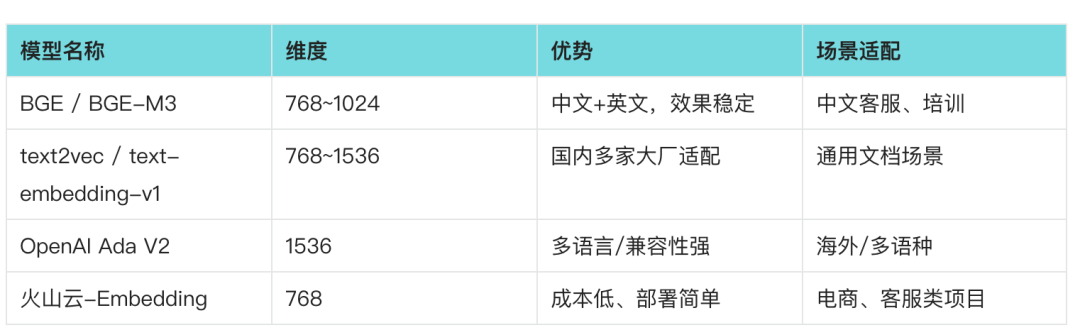
上面这张表列出的是常见嵌入模型的维度和适用面。真正选型时,要用自己的语料做一次检索对照,而不是按表里的形容词直接决定。
向量库保存这些向量,并带上文档名、章节和更新时间。本地演示可以很轻。正式使用时要能按范围过滤,避免把不该公开的片段召回到对外回答里。
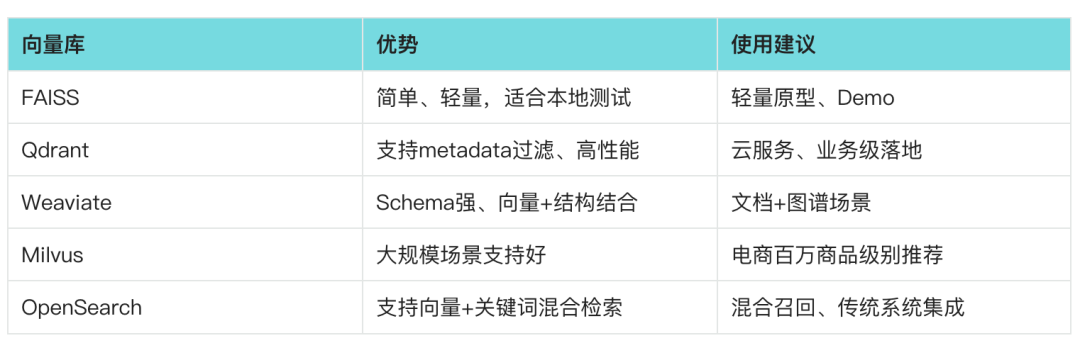
这张对照说明的是常见向量库各自适合什么场景。它是选型时的参考,不是煜见对容量或性能的承诺。
检索要能对上事实
只做向量相似,句子接近但事实不对的片段也会被召回。型号、条款编号、专有名词,往往要靠关键词才能找准。两路一起召回之后,再按与问题的相关程度重排,并限制送进模型的片段数量。
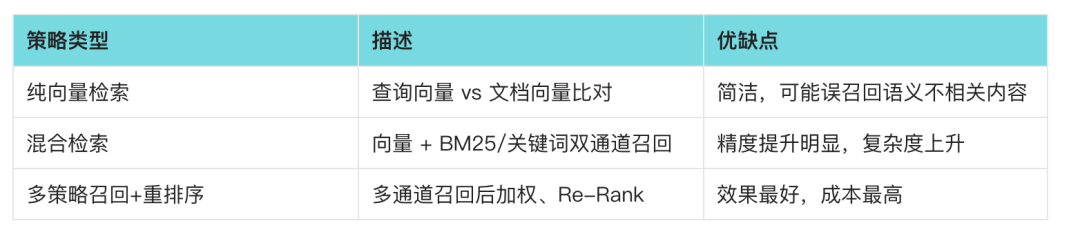
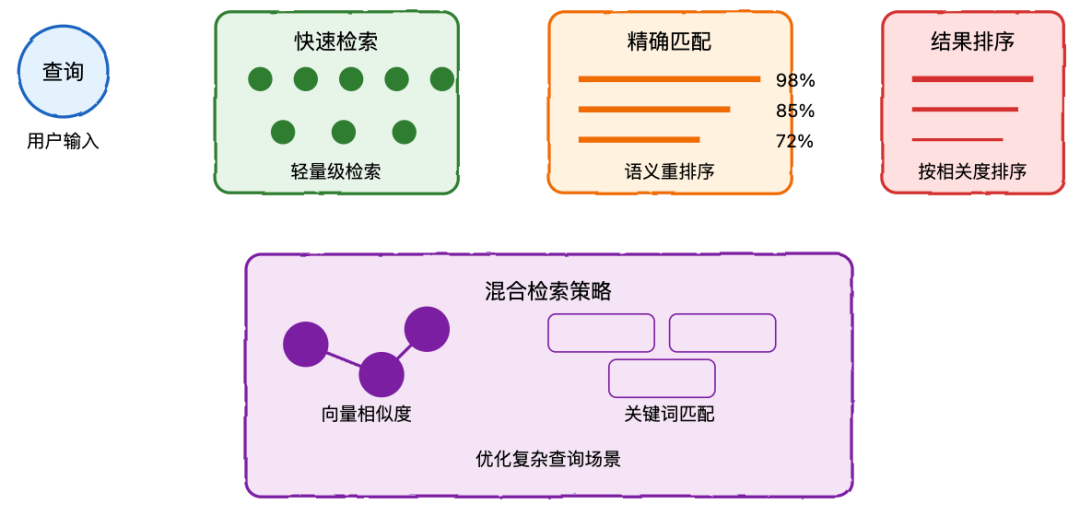
示意图里的百分比只表示排序位置,不是煜见测得的召回率。没有达到可用相关度的片段,就不组织答案,页面直接说明当前资料里没有可引用依据。
多轮对话不能把历史当成事实
追问里的“它”“刚才那个”,要先还原成一个完整问题,再去检索。历史对话可以帮忙消解指代,但不能代替知识库。历史里出现过的价格和日期,如果库里没有对应片段,就不能写进答案。
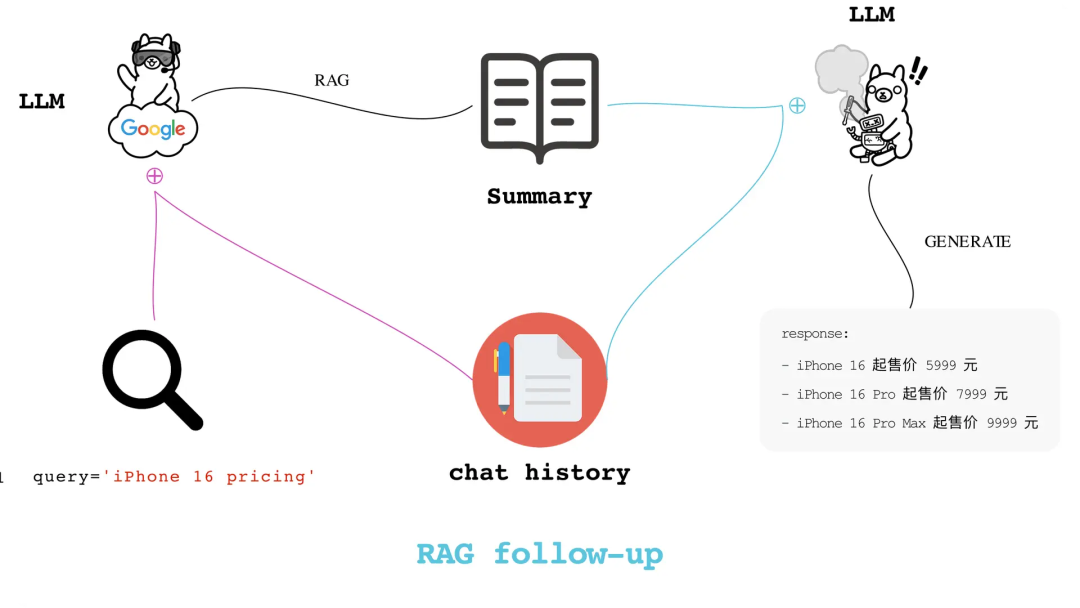
这张图演示的是追问如何带上对话历史。图里的商品价格只是示例,不是煜见的数据。
把调用次数和片段长度管住
一次回答的开销主要在两处:送进模型的片段有多长,以及模型被调用了几次。片段要短,同时要保持一句完整的话。重复问题可以复用同一次检索结果。模型只负责把已经召回的片段组织成话,不负责补齐库里没有的事实。
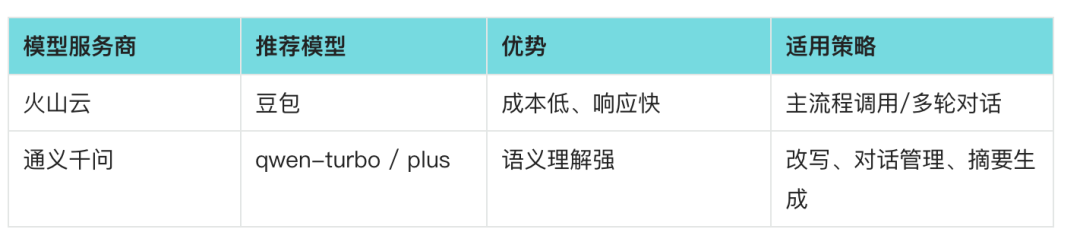
本站公开助手目前会使用火山引擎豆包和阿里云通义千问。这是现有站点的安排,不是对两家模型效果的排名。
工具可以换,规则不能省
编排工具负责切块、调用嵌入和接上对话。知识库本身是另一件事:哪些资料可以进入、每条片段的来源在哪里、没有依据时如何拒绝。工具可以更换,这三条规则不能省。
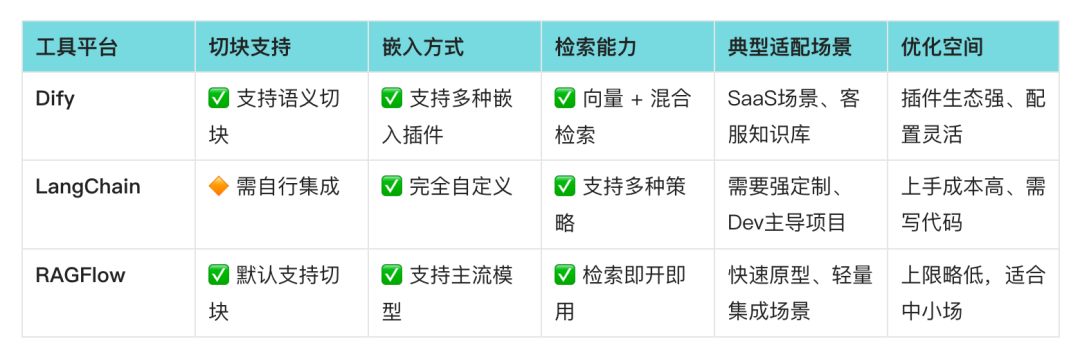
上表是常见编排工具的能力对照,用来帮助选型。煜见并不把知识库绑定在其中某一个工具上。
四道关都要过
- 资料关:只收已审核、来源清楚的文本。
- 检索关:嵌入、关键词和重排一起用,对不上就不作答。
- 对话关:追问先补全问题,历史不能冒充依据。
- 运行关:控制片段长度和调用次数,并留下这次回答用过的来源。
这项产品在官网中的位置,见 企业 RAG 知识库。